


课程
学堂在线测试 —— 编译原理
学堂在线测试 —— 编译原理
词法分析 习题
一、 单项选择题(本题共 27 小题,每小题 1 分,共 27 分)
1. 词法分析器的输入是 ( B )。
- A. 单词符号串
- B. 源程序
- C. 语法单位
- D. 目标程序
【解析】 词法分析器是编译器的第一个阶段,其输入是源程序(字符流),输出是单词符号串(Token 流)。
2. 词法分析阶段的任务是 ( B )。
- A. 识别表达式
- B. 识别单词
- C. 识别语言
- D. 识别程序
【解析】 词法分析阶段的核心任务是从源程序的字符流中识别出一个个有意义的单词(Token),如关键字、标识符、常量、运算符等。识别表达式和程序是语法分析的任务。
3. 编译过程中扫描器的任务包括 ( D )。 ① 组织源程序的输入 ② 按词法规则分割单词,识别出其属性,并转换成 Token 串输出 ③ 删除注解 ④ 删除空格及无用字符 ⑤ 行计数、列计数 ⑥ 发现并定位词法错误 ⑦ 建立符号表
- A. ②③④⑦
- B. ②③④⑥⑦
- C. ①②③④⑥⑦
- D. ①②③④⑤⑥⑦
【解析】 扫描器(词法分析器)的任务非常全面,包括:组织源程序输入(①)、按词法规则识别单词(②)、删除注解(③)、删除空格和无用字符(④)、行列计数以便错误定位(⑤)、发现词法错误(⑥)、建立符号表(⑦),因此全部都包含。
4. 在词法分析阶段不能识别的是 ( C )。
- A. 标识符
- B. 运算符
- C. 四元式
- D. 常数
【解析】 四元式(如
(op, arg1, arg2, result))是中间代码的一种表示形式,在中间代码生成阶段产生,不属于词法分析阶段能识别的内容。词法分析阶段能识别标识符、运算符和常数等单词符号。
5. 如图 3.2 所示的状态转换图接受的字集是 ( D )。
- A. 以 0 开头的二进制数组成的集合
- B. 以 0 结尾 of 二进制数组成的集合
- C. 含奇数个 0 的二进制数组成的集合
- D. 含偶数个 0 的二进制数组成的集合
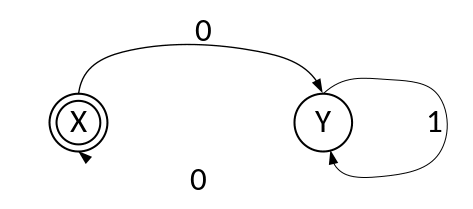
图 3.2 状态转换图
【解析】 该状态转换图中,初始状态即为接受状态,每读入一个 0 时在接受状态和非接受状态之间切换,读入 1 时状态不变。因此只有当输入中含偶数个 0(包括 0 个)时,自动机停留在接受状态。
6. 正规式 和 等价是指 ( C )。
- A. 和 的状态数相等
- B. 和 的有向弧条数相等
- C. 和 所表示的语言集相等
- D. 和 的状态数与有向弧条数相等
【解析】 两个正规式(或有限自动机)等价的定义是它们所表示(或接受)的语言集合相同,即 。状态数和有向弧数可以不同。
7. 与正规式 等价的正规式是 ( B )。
- A.
- B.
- C.
- D.
【解析】 表示由 和 组成的所有字符串(含空串)。 中 产生零个或多个 ,与 做选择后再取闭包,仍然产生 和 的所有组合,即 。而 不含空串, 要求 、 交替出现, 只允许纯 串或纯 串。
8. 词法分析器的输出结果是 ( B )。
- A. 单词的种别编码
- B. 单词的种别编号和属性值
- C. 单词的属性值
- D. 单词在符号表中的位置
【解析】 词法分析器输出的 Token 通常是一个二元组
(种别编号, 属性值),种别编号指明单词类型(关键字、标识符、常量等),属性值给出该单词的具体信息(如标识符名、常量值等)。
9. 编译过程中,对源程序进行词法分析的目的是 ( B )。
- A. 识别语句中的关键字
- B. 将源程序分解为具有独立意义的最小语法单位(单词)
- C. 检查源程序的语法错误
- D. 生成中间代码
【解析】 词法分析的目的是将源程序的字符流分解为一个个具有独立意义的最小语法单位——单词(Token)。识别关键字只是词法分析的一部分工作,不是全部目的;语法错误检查是语法分析的任务;中间代码生成是后续阶段的工作。
10. 词法分析器输出的单词符号通常不包括 ( C )。
- A. 关键字
- B. 标识符
- C. 表达式
- D. 常数
【解析】 表达式(如
a + b * c)是由多个单词组成的语法结构,属于语法分析阶段处理的对象,不是词法分析器输出的单词符号。词法分析器输出的单词符号类型包括关键字、标识符、常数、运算符和界限符等。
11. 下列哪项不属于词法分析器输出的单词符号类型 ( C )。
- A. 关键字 (如
if、while) - B. 标识符 (如变量名
x、函数名f) - C. 语法树节点
- D. 常量 (如整数
123、字符串"abc")
【解析】 语法树节点是语法分析阶段构建语法树时产生的,不属于词法分析器输出的单词符号类型。词法分析器输出关键字、标识符、常量、运算符和分隔符等 Token。
12. 词法分析中,“超前搜索” 是指 ( B )。
- A. 提前读取整个源程序再进行分析
- B. 为确定当前单词的边界,需要多读几个字符
- C. 同时分析多个源程序文件
- D. 跳过注释和空格等无关字符
【解析】 超前搜索(lookahead)是指在词法分析过程中,为了确定当前单词的确切边界或类型,需要向前多读取若干个字符进行判断,之后再回退到正确位置。例如读到
<时需要再看一个字符确定是<还是<=。
13. 正则表达式常被用于 ( B )。
- A. 描述语法规则
- B. 定义单词符号的结构
- C. 进行语义检查
- D. 生成目标代码
【解析】 正则表达式用于精确定义单词符号(Token)的词法结构,如标识符的模式
[a-zA-Z_][a-zA-Z0-9_]*。语法规则通常用上下文无关文法(BNF)描述,语义检查和目标代码生成与正则表达式无关。
14. 下列关于词法分析与语法分析的关系,说法正确的是 ( B )。
- A. 词法分析必须独立于语法分析先行完成
- B. 词法分析可以作为语法分析的子过程,按需调用
- C. 语法分析的结果会影响词法分析的过程
- D. 两者没有关联,可并行进行
【解析】 在实际编译器实现中,词法分析器通常作为语法分析器的子过程,语法分析器每次需要下一个 Token 时就调用词法分析器获取。这种方式避免了一次性处理所有 Token 的开销。
15. 词法分析阶段不负责处理的错误是 ( C )。
- A. 非法字符 (如源程序中出现
@但文法不允许) - B. 关键字拼写错误 (如
whle代替while) - C. 变量未声明
- D. 常量格式错误 (如
12a3不是合法整数)
【解析】 “变量未声明”属于语义错误,需要在语义分析阶段通过查询符号表来发现。词法分析阶段能发现非法字符、关键字拼写错误(会被识别为标识符而非关键字)、常量格式错误等词法层面的问题。
16. 下列关于单词符号 (Token) 的描述,正确的是 ( B )。
- A. 每个 Token 仅包含单词的类型,不包含具体值
- B. 标识符作为 Token 时,其值是标识符的名称
- C. 关键字的 Token 值通常为空
- D. 运算符的 Token 类型无需区分(如
+和*视为同一类型)
【解析】 Token 是二元组
(类型, 值),标识符 Token 的值就是标识符的名称(如"x"、"count"等)。A 错误,Token 包含类型和值;C 错误,关键字的 Token 值通常是关键字本身;D 错误,不同运算符需区分类型以便后续处理。
17. 词法分析中处理注释和空格的方式通常是 ( B )。
- A. 将其作为特殊 Token 输出
- B. 忽略它们,不纳入 Token 流
- C. 报错并终止编译
- D. 替换为特定字符后保留
【解析】 注释和空格(包括换行、制表符等空白字符)在词法分析阶段会被识别并跳过,不会作为 Token 输出到 Token 流中,因为它们对程序的语义没有影响。
18. 下列工具中,专门用于生成词法分析器的是 ( B )。
- A. Yacc/Bison
- B. Lex/Flex
- C. GCC
- D. Java Compiler
【解析】 Lex/Flex 是专门用于自动生成词法分析器的工具,用户提供正则表达式规则,工具自动生成对应的 C 语言词法分析程序。Yacc/Bison 是语法分析器生成工具,GCC 和 Java Compiler 是完整的编译器。
19. 词法分析器在识别单词时,通常依据的是 ( B )。
- A. 上下文无关文法
- B. 正则文法
- C. 上下文有关文法
- D. 短语结构文法
【解析】 词法分析器识别的单词符号(如标识符、常量、关键字等)的结构可以用正则表达式(正则文法/3 型文法)来描述,因此词法分析器依据正则文法工作。上下文无关文法用于语法分析。
20. 在 C 语言中,词法分析器遇到字符串 "123abc" 时,会将其识别为 ( C )。
- A. 一个整数常量
- B. 一个标识符
- C. 非法单词(错误)
- D. 整数和标识符的组合
【解析】 在 C 语言的词法分析阶段,编译器遵循严格的构词规则。对于字符串
123abc,词法分析器的处理逻辑如下:
- 不可能是标识符:C 语言明确规定,标识符(如变量名、函数名)必须以字母(A-Z, a-z)或下划线(_)开头,绝对不能以数字开头。
- 不可能是合法的数字常量:当词法分析器扫描到首字符是数字
1时,它会按照解析“数字常量”的规则继续向后读取。读取完123后,遇到了字母a。在 C 语言中,除了特定的后缀(如无符号数后缀U,长整数后缀L等)或者十六进制/科学计数法中的特定字母(如x,e)外,普通的字母不能直接紧跟在十进制数字后面。- 最长匹配原则(贪婪匹配):C 语言的词法分析器遵循“最长匹配原则”(Maximal Munch)。这意味着它会尽可能长地读取能构成一个单独词法单元的字符,而不会自动将它们截断拆分。因此,它不会将其理解为
123(整数)和abc(标识符)的组合,而是将123abc作为一个整体。由于这个整体违反了常量的构造规则,词法分析器会将其判定为 非法单词 并报错。
21. 词法分析中,“最长匹配原则” 是指 ( B )。
- A. 优先选择长度最长的产生式进行推导
- B. 从输入串中尽可能长地提取一个合法单词
- C. 优先匹配包含字符最多的关键字
- D. 对不确定的单词选择最长的可能类型
【解析】 最长匹配原则(Maximal Munch)是指词法分析器在识别单词时,总是从当前位置出发尽可能多地读取字符,使得提取出的单词尽可能长。例如
>=会被识别为一个”大于等于”运算符,而不是>和=两个 Token。
22. 词法分析器的输出结果被直接用于 ( C )。
- A. 语义分析
- B. 代码生成
- C. 语法分析
- D. 代码优化
【解析】 词法分析器输出的 Token 流直接作为语法分析器的输入。编译的各阶段顺序为:词法分析 → 语法分析 → 语义分析 → 中间代码生成 → 代码优化 → 目标代码生成。
23. 下列哪种情况不属于词法错误 ( C )。
- A. 源程序中出现未定义的运算符
\$ - B. 字符串缺少闭合引号 (如
"hello) - C. 函数调用时实参与形参类型不匹配
- D. 数值常量中出现字母 (如
12.3e-4f是合法的,但12a3不合法)
【解析】 “函数调用时实参与形参类型不匹配”属于语义错误,需要在语义分析阶段通过类型检查来发现,不属于词法错误。其他选项涉及的都是字符级别的错误,属于词法分析阶段可以发现的问题。
24. 有限自动机中, 转换 the 含义是 ( B )。
- A. 输入任意字符均可转换状态
- B. 无需输入字符即可从一个状态转换到另一个状态
- C. 转换失败时的默认状态
- D. 只能在初始状态使用的转换
【解析】 转换(空转换)是指有限自动机在不读入任何输入字符的情况下,就可以自发地从一个状态转移到另一个状态。这是 NFA 的特征之一,DFA 中不允许 转换。
25. NFA 中的 -转换 (空转换) 表示 ( B )。
- A. 输入一个特殊的 "" 符号时的状态转换
- B. 不输入任何符号即可进行的状态转换
- C. 只有接受状态才能进行的转换
- D. 从初始状态出发的唯一转换
【解析】 -转换表示不需要消耗任何输入符号就可以进行的状态转换。 不是一个实际的输入符号,而是表示”空”的概念,意味着自动机可以自发地进行该转换。
26. 将 NFA 转换为等价 DFA 的过程中,核心步骤是 ( C )
- A. 消除所有接受状态
- B. 合并所有初始状态
- C. 用 “状态子集” 表示 DFA 的状态(子集构造法)
- D. 增加 -转换
【解析】 NFA 转换为 DFA 的核心方法是子集构造法(Subset Construction)。该方法将 NFA 状态的子集作为 DFA 的一个状态,通过计算 -闭包和状态转移来构建等价的 DFA。
27. 若两个有限自动机等价,则它们 ( B )
- A. 状态数相同
- B. 接受的语言相同
- C. 都有 -转换
- D. 初始状态数量相同
【解析】 两个有限自动机等价的充要条件是它们接受(识别)的语言相同,即 。等价的自动机可以有不同的状态数、不同的结构,一个可以是 NFA(有 -转换),另一个可以是 DFA(无 -转换)。
二、 多项选择题(本题共 5 小题,每小题 2 分,共 10 分。多选、少选、错选均不得分)
1. 有限自动机中,确定有限自动机 (DFA) 与非确定有限自动机 (NFA) 的主要区别是 ( B, D )。
- A. DFA 的状态数更少
- B. DFA 对于每个输入符号只有一个后继状态
- C. NFA 不能识别正规语言
- D. DFA 没有空转移
【解析】 DFA 与 NFA 的主要区别有两点:(1)DFA 的转换函数是单值的,即对于每个状态和输入符号,最多只有一个后继状态(B 正确);(2)DFA 没有 -转换(空转移)(D 正确)。A 错误,DFA 的状态数不一定更少(子集构造可能导致状态数指数增长);C 错误,NFA 和 DFA 识别能力相同,都能识别正规语言。 A存疑,标准答案上写的有A
2. 有限自动机与词法分析的关系是 ( B )。
- A. 有限自动机是描述语法规则 of 工具
- B. 确定有限自动机 (DFA) 可直接用于实现词法分析器
- C. 非确定有限自动机 (NFA) 无法转换为词法分析器
- D. 有限自动机用于优化目标代码
【解析】 DFA 可以直接用于实现词法分析器,因为 DFA 的状态转换是确定的,可以高效地识别正则语言描述的单词模式(B 正确)。A 错误,有限自动机描述的是词法规则而非语法规则;C 错误,NFA 可以通过子集构造法转换为 DFA 再用于词法分析;D 错误,有限自动机与目标代码优化无关。 A存疑,答案有A
3. 下列关于确定有限自动机 (DFA) 的说法,正确的是 ( C )。
- A. DFA 中存在多个初始状态
- B. 对于某个状态和输入字符,可能有多个下一状态
- C. DFA 的状态转换是确定的,可直接用于实现词法分析
- D. DFA 无法识别正则语言
【解析】 C 正确:DFA 的核心特征就是状态转换的确定性,对于每个状态和输入符号只有唯一的后继状态,因此可以直接用于实现词法分析器。A 错误,DFA 只有一个初始状态;B 错误,这是 NFA 的特征;D 错误,DFA 正是用来识别正则语言的。
答案ACD存疑
DFA 有且仅有一个初始状态,对任意状态和输入字符,最多只有一个下一状态(确定性),这一特性使其适合直接编程实现词法分析;DFA 正是用于识别正则语言的工具。
4. 非确定有限自动机 (NFA) 与 DFA 的主要区别在于 ( B )。
- A. NFA 不能识别正则语言,DFA 可以
- B. NFA 的状态转换可能不确定(同一状态和输入有多个下一状态)
- C. NFA 没有接受状态,DFA 有
- D. NFA 只能处理短输入串,DFA 可处理任意长度
【解析】 NFA 与 DFA 的主要区别是 NFA 的转换函数是多值的,即同一状态在同一输入符号下可以有多个后继状态(B 正确)。A 错误,NFA 和 DFA 识别能力等价;C 错误,NFA 也有接受状态;D 错误,NFA 和 DFA 都可以处理任意长度的输入串。 答案AB存疑
NFA 允许同一状态对同一输入字符有多个转换,或有 ε 转换(无需输入字符即可转换),因此状态转换具有不确定性;但 NFA 和 DFA 识别的语言类相同(均为正则语言),且都有初始状态和接受状态。
5. 下列关于确定有限自动机 (DFA) 的描述,正确的是 ( C, D )。
- A. DFA 的一个状态对同一输入符号可以有多个不同的后继状态
- B. DFA 的初始状态可以有多个
- C. DFA 的转换函数是从 “状态 × 输入符号” 到 “状态” 的单值映射
- D. DFA 可以没有接受状态
【解析】 C 正确:DFA 的转换函数 是单值映射,这是 DFA “确定性”的体现。D 正确:从定义上说,DFA 可以没有接受状态(此时它不接受任何字符串,识别空语言 )。A 错误,这是 NFA 的特征;B 错误,DFA 只有一个初始状态。 答案是ACD存疑
DFA 的核心特征是 “确定性”: 转换函数 δ:Q×Σ→Q 是单值映射(每个状态对每个输入符号有且仅有一个后继状态),对应选项 C;选项 A 错误,这是 NFA 的特征;选项 B 错误,DFA 有且仅有一个初始状态;选项 D 错误,DFA 可以没有接受状态(此时它接受的语言为空集),但此描述本身不违反 DFA 定义,不过相比之下 C 是更本质的正确特征。
三、 填空题(本题共 1 小题,每小题 10 分,共 10 分)
1. 令 , 上的正规式 代表的语言是 ______ 上所有含有两个连续相同字母(即含有子串 或 )的字符串的集合。
【解析】 分析正规式结构: 匹配任意前缀, 要求出现子串 或 , 匹配任意后缀。因此该正规式描述的是 上所有包含至少一个连续相同字母对( 或 )的字符串的集合。
四、 主观题(本题共 1 小题,每小题 10 分,共 10 分)
1. 为正规式 构造与之等价且状态最少的 DFA。
【参考答案】
第一步:分析正规式
正规式 表示:以 开头,以 结尾,中间可以是任意个 或 的字符串。
第二步:构造最小 DFA
最小 DFA 共有 5 个状态:(起始状态)、、、(接受状态)、(死状态/陷阱状态)。
状态转换表:
状态 输入 输入 说明 (起始) 起始状态,必须读入 已读入开头的,等待 已读入一个,再读 则到接受态 (接受) 已匹配 结尾,接受状态 (死状态) 陷阱状态,无法到达接受态 状态转换说明:
- :起始状态。读入 转到 ;读入 转到死状态 (因为字符串必须以 开头)
- :已读入首字符 ,进入 部分。读入 转到 (开始匹配末尾的 );读入 留在
- :已读入一个 。读入 转到 (匹配到 ,接受);读入 回到 ( 匹配中断)
- :接受状态(已匹配到末尾的 )。读入 留在 (仍以 结尾);读入 回到 (不再以 结尾)
- :死状态(陷阱状态),读入任何字符都留在
状态转换图:
         b          a          a
 →(q0) ----→ (q1) ----→ (q2) ----→ ((q3))
    |         ↑ ↓b        ↑ ↓b        ↑ ↓b   ↑↓a
    |a        └─┘         │           │       └┘
    ↓                     └───────────┘
   (qd)                    (b回到q1)
   ↑↓a,b
   └─┘
验证示例:
- : ✓(接受)
- : ✓(接受)
- : ✗(不接受)
- : ✗(不接受,未以 开头)