《编译原理》期末试题(一)#
一、是非题(请在括号内,正确的划√,错误的划×)(每个2分,共20分)#
1. 编译程序是对高级语言程序的解释执行。(×)
2. 一个有限状态自动机中,有且仅有一个唯一的终态。(×)
3. 一个算符优先文法可能不存在算符优先函数与之对应。(√)
4. 语法分析时必须先消除文法中的左递归。(×)
5. LR分析法在自左至右扫描输入串时就能发现错误,但不能准确地指出出错地点。(√)
6. 逆波兰表示法表示表达式时无须使用括号。(√)
7. 静态数组的存储空间可以在编译时确定。(×)
8. 进行代码优化时应着重考虑循环的代码优化,这对提高目标代码的效率将起更大作用。(×)
9. 两个正规集相等的必要条件是他们对应的正规式等价。(×)
10. 一个语义子程序描述了一个文法所对应的翻译工作。(×)
二、选择题(请在前括号内选择最确切的一项作为答案划一个勾,多划按错论)(每个4分,共40分)#
1. 词法分析器的输出结果是_____。
- A. 单词的种别编码
- B. 单词在符号表中的位置
- C. 单词的种别编码和自身值
- D. 单词自身值
2. 正规式 M1 和 M2 等价是指_____。
- A. M1 和 M2 的状态数相等
- B. M1 和 M2 的有向边条数相等
- C. M1 和 M2 所识别的语言集相等
- D. M1 和 M2 状态数和有向边条数相等
3. 文法 G:S→xSx∣y 所识别的语言是_____。
- A. xyx
- B. (xyx)∗
- C. xnyxn(n≥0)
- D. x∗yx∗
4. 如果文法 G 是无二义的,则它的任何句子 α _____。
- A. 最左推导和最右推导对应的语法树必定相同
- B. 最左推导和最右推导对应的语法树可能不同
- C. 最左推导和最右推导必定相同
- D. 可能存在两个不同的最左推导,但它们对应的语法树相同
5. 构造编译程序应掌握______。
- A. 源程序
- B. 目标语言
- C. 编译方法
- D. 以上三项都是
6. 四元式之间的联系是通过_____实现的。
- A. 指示器
- B. 临时变量
- C. 符号表
- D. 程序变量
7. 表达式 (¬A∨B)∧(C∨D) 的逆波兰表示为_____。
- A. ¬AB∨∧CD∨
- B. A¬B∨CD∨∧
- C. AB∨¬CD∨∧
- D. A¬B∨∧CD∨
8. 优化可生成_____的目标代码。
- A. 运行时间较短
- B. 占用存储空间较小
- C. 运行时间短但占用内存空间大
- D. 运行时间短且占用存储空间小
9. 下列______优化方法不是针对循环优化进行的。
- A. 强度削弱
- B. 删除归纳变量
- C. 删除多余运算
- D. 代码外提
10. 编译程序使用_____区别标识符的作用域。
- A. 说明标识符的过程或函数名
- B. 说明标识符的过程或函数的静态层次
- C. 说明标识符的过程或函数的动态层次
- D. 标识符的行号
三、填空题(每空1分,共10分)#
1. 计算机执行用高级语言编写的程序主要有两种途径:解释__和__编译。
2. 扫描器是__词法分析器___,它接受输入的__源程序___,对源程序进行___词法分析__并识别出一个个单词符号,其输出结果是单词符号,供语法分析器使用。
3. 自上而下分析法采用___移进__、归约、错误处理、___接受__等四种操作。
4. 一个LR分析器包括两部分:一个总控程序和___一张分析表__。
5. 后缀式 abc−/ 所代表的表达式是___a/(b−c)__。
6. 局部优化是在__基本块___范围内进行的一种优化。
四、简答题(20分)#
1. 简要说明语义分析的基本功能。
答:语义分析的基本功能包括:确定类型、类型检查、语义处理和某些静态语义检查。
2. 考虑文法 G[S]:
S→(T)∣a+S∣a
T→T,S∣S
消除文法的左递归及提取公共左因子。
解:消除文法 G[S] 的左递归:
S→(T)∣a+S∣a
T→ST′
T′→,ST′∣ε
提取公共左因子:
S→(T)∣aS′
S′→+S∣ε
T→ST′
T′→,ST′∣ε
3. 试为表达式 w+(a+b)∗(c+d/(e−10)+8) 写出相应的逆波兰表示。
解:wab+cde10−/+8+∗+
4. 已知文法 G[S] 为 S→aSb∣Sb∣b,试证明文法 G[S] 为二义文法。
证明:由文法 G[S]:S→aSb∣Sb∣b,对句子 aabbbb 可以构造两棵不同的语法树。因此,文法 G[S] 为二义文法。
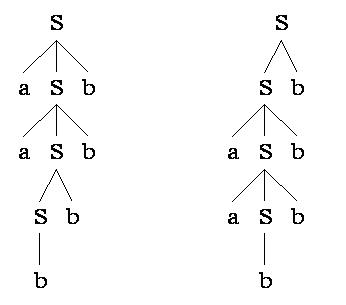
图 4.1 aabbbb 的两棵语法树
五、计算题(10分)#
已知文法 A→aAd∣aAb∣ε,判断该文法是否是 SLR(1) 文法,若是构造相应分析表,并对输入串 ab# 给出分析过程。
下面构造它的 LR(0) 项目集规范族与转换关系表:
| 状态 | a | b | d | # | A |
|---|
I0:
S′→⋅A
A→⋅aAd
A→⋅aAb
A→⋅ | I2:
A→a⋅Ad
A→a⋅Ab
A→⋅aAd
A→⋅aAb
A→⋅ | | | | I1:
S′→A⋅ |
I1:
S′→A⋅ | | | | acc | |
I2:
A→a⋅Ad
A→a⋅Ab
A→⋅aAd
A→⋅aAb
A→⋅ | I2 | | | | I3:
A→aA⋅d
A→aA⋅b |
I3:
A→aA⋅d
A→aA⋅b | | I4:
A→aAb⋅ | I5:
A→aAd⋅ | | |
I4:
A→aAb⋅ | | | | | |
I5:
A→aAd⋅ | | | | | |
从上表可看出,状态 I0 和 I2 存在移进-归约冲突,该文法不是 LR(0) 文法。对于 I0 来说有:FOLLOW(A)∩{a}={b,d,#}∩{a}=Φ,所以在 I0 状态下面临输入符号为 a 时移进,为 b,d,# 时归约,为其他时报错。对于 I2 来说也有与 I0 完全相同的结论。这就是说,以上的移进-归约冲突是可以解决的,因此该文法是 SLR(1) 文法。其 SLR(1) 分析表如下表所示:
| 状态 | ACTION | | | | GOTO |
|---|
| a | b | d | # | A |
| 0 | S2 | r3 | r3 | r3 | 1 |
| 1 | | | | acc | |
| 2 | S2 | r3 | r3 | r3 | 3 |
| 3 | | S4 | S5 | | |
| 4 | r2 | r2 | r2 | r2 | |
| 5 | r1 | r1 | r1 | r1 | |
对输入串 ab# 的分析过程如下表所示:
| 步骤 | 状态栈 | 符号栈 | 输入串 | ACTION | GOTO |
|---|
| 1 | 0 | # | ab# | S2 | |
| 2 | 0 2 | #a | b# | r3(A→ε) | 3 |
| 3 | 0 2 3 | #aA | b# | S4 | |
| 4 | 0 2 3 4 | #aAb | # | r2(A→aAb) | 1 |
| 5 | 0 1 | #A | # | acc | |
《编译原理》期末试题(二)#
一、是非题#
1. 一个上下文无关文法的开始符,可以是终结符或非终结符。(×)
2. 一个句型的直接短语是唯一的。(×)
3. 已经证明文法的二义性是可判定的。(×)
4. 每个基本块可用一个DAG表示。(√)
5. 每个过程的活动记录的体积在编译时可静态确定。(√)
6. 2型文法一定是3型文法。(×)
7. 一个句型一定是句子。(×)
8. 算符优先分析法每次都是对句柄进行归约。(×)
9. 采用三元式实现三地址代码时,不利于对中间代码进行优化。(√)
10. 编译过程中,语法分析器的任务是分析单词是怎样构成的。(×)
11. 一个优先表一定存在相应的优先函数。(×)
12. 目标代码生成时,应考虑如何充分利用计算机的寄存器的问题。(√)
13. 递归下降分析法是一种自下而上分析法。(×)
14. 并不是每个文法都能改写成LL(1)文法。(√)
15. 每个基本块只有一个入口和一个出口。(√)
16. 一个LL(1)文法一定是无二义的。(√)
17. 逆波兰法表示的表达式亦称前缀式。(×)
18. 目标代码生成时,应考虑如何充分利用计算机的寄存器的问题。(√)
19. 正规文法产生的语言都可以用上下文无关文法来描述。(√)
20. 一个优先表一定存在相应的优先函数。(×)
21. 3型文法一定是2型文法。(√)
22. 如果一个文法存在某个句子对应两棵不同的语法树,则文法是二义性的。(√)
答案:1.× 2.× 3.× 4.√ 5.√ 6.× 7.× 8.× 9.√ 10.× 11.× 12.√ 13.× 14.√ 15.√ 16.√ 17.× 18.√ 19.√ 20.× 21.√ 22.√
二、填空题#
1. 编译过程可分为(词法分析),(语法分析),(语义分析与中间代码生成),(优化)和(目标代码生成)五个阶段。
2. 如果一个文法存在某个句子对应两棵不同的语法树,则称这个文法是(二义性的)。
3. 从功能上说,程序语言的语句大体可分为(执行性)语句和(说明性)语句两大类。
4. 语法分析器的输入是(单词符号),其输出是(语法单位)。
5. 扫描器的任务是从(源程序)中识别出一个个(单词符号)。
6. 符号表中的信息栏中登记了每个名字的有关的性质,如(类型、种属、所占单元大小、地址)等等。
7. 一个过程相应的DISPLAY表的内容为(现行活动记录地址和所有外层最新活动记录的地址)。
8. 常用的两种动态存贮分配办法是(栈式)动态分配和(堆式)动态分配。
9. 一个名字的属性包括(类型)和(作用域)。
10. 常用的参数传递方式有(传地址),(传值),(传名)。
11. 根据优化所涉及的程序范围,可将优化分成为(局部优化),(循环优化),(全局优化)三个级别。
12. 语法分析的方法大致可分为两类,一类是(自上而下)分析法,另一类是(自下而上)分析法。
13. 预测分析程序是使用一张(分析表)和一个(符号栈)进行联合控制的。
14. 一张转换图只包含有限个状态,其中有一个被认为是(初)态;而且实际上至少要有一个(终)态。
15. 语法分析是依据语言的(语法)规则进行。中间代码产生是依据语言的(语义)规则进行的。
16. 一个文法 G,若它的预测分析表 M 不含多重定义,则该文法是(LL(1) 文法)。
17. 对于数据空间的存贮分配,FORTRAN采用(静态)策略,PASCAL采用(动态)策略。
18. 最右推导亦称为(规范推导),由此得到的句型称为(规范)句型。
19. 对于文法 G,仅含终结符号的句型称为(句子)。
20. 所谓自上而下分析法是指(从开始符号出发,向下推导,推出句子)。
21. 局限于基本块范围的优化称(局部优化)。
22. 2型文法又称为(上下文无关)文法;3型文法又称为(正则)文法。
23. 每条指令的执行代价定义为(指令访问主存次数加1)。
24. 算符优先分析法每次都是对(最左素短语)进行归约。
三、简答题#
1. 写一个文法 G,使其语言为不以0开头的偶数集。
答:所求文法是 G[S]:
S→AB∣B
A→AD∣C
B→2∣4∣6∣8
C→1∣3∣5∣7∣9∣B
D→0∣C
2. 已知文法 G(S) 及相应翻译方案
S→aAb {print "1"}
S→a {print "2"}
A→AS {print "3"}
A→c {print "4"}
输入 acab,输出是什么?
答:输出是 4231。
3. 已知文法 G(S)
S→bAa
A→(B∣a
B→Aa)
写出句子 b(aa)b 的规范归约过程。
答:句子 b(aa)b 的规范归约过程:
| 步骤 | 符号栈 | 输入串 | 动作 |
|---|
| 0 | # | b(aa)b# | 预备 |
| 1 | #b | (aa)b# | 移进 |
| 2 | #b( | aa)b# | 移进 |
| 3 | #b(a | a)b# | 移进 |
| 4 | #b(A | a)b# | 归约 |
| 5 | #b(Ma | )b# | 移进 |
| 6 | #b(Ma) | b# | 移进 |
| 7 | #b(B | b# | 归约 |
| 8 | #bA | b# | 归约 |
| 9 | #bAb | # | 移进 |
| 10 | #S | # | 接受 |
4. 考虑下面的程序:
procedure p(x, y, z);
begin
  y:=x+y;
  z:=z*z;
end
begin
  A:=2;
  B:=A*2;
  P(A, A, B);
  Print A, B
end.
试问,若参数传递的方式分别采用传地址和传值时,程序执行后输出 A, B 的值是什么?
答:传地址 A=6, B=16;传值 A=2, B=4。
5. 文法 G(S)
S→dAB
A→aA∣a
B→Bb∣ε
描述的语言是什么?
答:L(G)={danbm∣n>0,m≥0}。
6. 证明文法 G(S):S→SaS∣ε 是二义性的。
证明:因为文法 G[S] 存在句子 aa 有两个不同的最左推导,所以文法 G[S] 是二义性的。
S⇒SaS⇒SaSaS⇒aSaS⇒aaS⇒aa
S⇒SaS⇒aS⇒aSaS⇒aaS⇒aa
7. 已知文法 G(S)
S→BA
A→BS∣d
B→aA∣bS∣c
的预测分析表如下:
| a | b | c | d | # |
|---|
| S | S→BA | S→BA | S→BA | | |
| A | A→BS | A→BS | A→BS | A→d | |
| B | B→aA | B→bS | B→c | | |
给出句子 adccd 的分析过程。
答:句子 adccd 的分析过程:
| 步骤 | 符号栈 | 输入串 | 产生式 |
|---|
| 0 | #S | adccd# | |
| 1 | #BA | adccd# | S→BA |
| 2 | #BaA | adccd# | B→aA |
| 3 | #BA | dccd# | 匹配 a |
| 4 | #Bd | dccd# | A→d |
| 5 | #B | ccd# | 匹配 d |
| 6 | #BSc | ccd# | A→BS |
| 7 | #BS | cd# | 匹配 c |
| 8 | #Bc | cd# | B→c |
| 9 | #B | d# | 匹配 c |
| 10 | #BaA | d# | B→aA |
| 11 | #Ba | # | A→d(错误) |
(注:原题答案存在格式问题,此处保留原题分析框架。)
8. 写一个文法 G,使其语言为 L(G)={albmclanbn∣l≥0,m≥1,n≥2}。
答:所求文法是 G[S]:
S→AB
A→aAc∣D
D→bD∣b
B→aBb∣aabb
9. 已知文法 G(S):
S→a∣(T)
T→T,S∣S
的优先关系表如下:
| a | ( | ) | , | # |
|---|
| a | | | > | > | > |
| ( | < | < | = | < | |
| ) | | | > | > | > |
| , | < | < | > | > | |
| # | < | < | | | = |
请计算出该优先关系表所对应的优先函数表。
答:
| f | g |
|---|
| a | 4 | 5 |
| ( | 2 | 4 |
| ) | 5 | 2 |
| , | 4 | 3 |
| # | 1 | 1 |
10. 何谓优化?按所涉及的程序范围可分为哪几级优化?
答:优化:对程序进行各种等价变换,使得从变换后的程序出发,能产生更有效的目标代码。三种级别:局部优化、循环优化、全局优化。
11. 目标代码有哪几种形式?生成目标代码时通常应考虑哪几个问题?
答:目标代码通常采用三种形式:机器语言、汇编语言、待装配机器语言模块。应着重考虑的问题:(1) 如何使生成的目标代码较短;(2) 如何充分利用寄存器,以减少访问内存次数;(3) 如何充分利用指令系统的特点。
12. 一字母表 Σ={a,b},试写出 Σ 上所有以 a 为首的字组成的正规集相对应的正规式。
答:正规式 a(a∣b)∗。
13. 基本的优化方法有哪几种?
答:删除多余运算,代码外提,强度削弱,变换循环控制条件,合并已知量,复写传播和删除无用赋值。
14. 写一个文法 G,使其语言为 L(G)={abncn∣n≥0}。
答:文法 G[S]:
S→aB∣a
B→bc∣bBc
15. 考虑下面的程序:
procedure p(x, y, z);
begin
  y:=y+z;
  z:=y*z+x
end;
begin
  a:=5;
  b:=2;
  p(a+b, a-b, a);
  print a
end.
试问,若参数传递的方式分别采用传地址和传值时,程序执行后输出 a 的值是什么?
答:传值 a=2;传地址 a=15。
16. 写出表达式 a+b∗(c−d)/e 的逆波兰式和三元序列。
答:逆波兰式:abcd−∗e/+
三元序列:
| op | arg1 | arg2 |
|---|
| (1) | − | c | d |
| (2) | ∗ | b | (1) |
| (3) | / | (2) | e |
| (4) | + | a | (3) |
17. 证明文法 G(A):A→AA∣(A)∣ε 是二义性的。
证明:因为文法 G[A] 存在句子 () 有两个不同的最左推导,所以文法 G[A] 是二义性的。
A⇒AA⇒(A)A⇒()A⇒()
A⇒AA⇒A⇒(A)⇒()
18. 令 Σ={a,b},则正规式 a∗b∣b∗a 表示的正规集是什么?
答:{a∗b∣b∗a}={a,b,ab,ba,aab,bba,…}
19. 何谓DISPLAY表?其作用是什么?
答:DISPLAY表是嵌套层次显示表。由于过程嵌套允许内层过程引用外层过程定义的数据,因此,当一个过程运行时必须跟踪它的所有外层过程的最新活动记录起始地址,DISPLAY表就是用于登记每个外层过程的最新活动记录起始地址。
20. 考虑下面的程序:
procedure p(x, y, z);
begin
  y:=y+2;
  z:=z+x;
end
begin
  a:=5;
  b:=2;
  p(a+b, a-b, a);
  print a
end.
试问,若参数传递的方式分别采用传地址和传值时,程序执行后输出 a 的值是什么?
答:传地址 a=12;传值 a=5。
21. 写一个文法 G,使其语言为 L(G)={anbncm∣n>0 为奇数,m>0 为偶数}。
答:所求文法是 G[S]:
S→AC
A→aaAbb∣ab
C→ccC∣cc
22. 写出表达式 a:=(b+c)∗e+(b+c)/f 的逆波兰式和三元序列。
答:逆波兰式:abc+e∗bc+f/+:=
三元序列:
| op | arg1 | arg2 |
|---|
| (1) | + | b | c |
| (2) | ∗ | (1) | e |
| (3) | + | b | c |
| (4) | / | (3) | f |
| (5) | + | (2) | (4) |
| (6) | := | a | (5) |
23. 一个文法 G 是 LL(1) 文法的充要条件是什么?
答:一个文法 G 是 LL(1) 文法的充要条件是:
(1) FIRST(α)∩FIRST(β)=Φ
(2) 如果 β⇒∗ε,则 FIRST(α)∩FOLLOW(A)=Φ
24. 已知文法 G[S]
S→S∗aF∣aF∣∗aF
F→+aF∣+a
消除文法左递归和提公共左因子。
答:消除左递归:
S→aFS′∣∗aFS′
S′→∗aFS′∣ε
F→+aF∣+a
提公共左因子,文法 G′(S):
S→aFS′∣∗aFS′
S′→∗aFS′∣ε
F→+aF′
F′→F∣ε
25. 符号表的作用是什么?符号表查找和整理技术有哪几种?
答:作用:登记源程序中出现的各种名字及其信息,以及了解各阶段的进展状况。主要技术:线性表,对折查找,杂凑技术。
四、简答题(续)#
1. 设文法 G(S):
S→ˆ∣a∣(T)
T→T,S∣S
(1) 消除左递归;
(2) 构造相应的FIRST和FOLLOW集合;
(3) 构造预测分析表。
2. 语句 if E then S
(1) 改写文法,使之适合语法制导翻译;
(2) 写出改写后产生式的语义动作。
3. 设某语言的for语句的形式为
for i:=E(1) to E(2) do S
其语义解释为
i:=E(1)
LIMIT:=E(2)
again: if i<=LIMIT then
  Begin
    i:=i+1
    goto again
  End;
(1) 写出适合语法制导翻译的产生式;
(2) 写出每个产生式对应的语义动作。
4. 把语句
while a<10 do
  if c>0 then a:=a+1
  else a:=a*3-1;
翻译成四元式序列。
答:
| 四元式 |
|---|
| (1) | (j<,a,10,(3)) |
| (2) | (j,_,_,(12)) |
| (3) | (j>,c,0,(5)) |
| (4) | (j,_,_,(8)) |
| (5) | (+,a,1,T1) |
| (6) | (:=,T1,_,a) |
| (7) | (j,_,_,(1)) |
| (8) | (∗,a,3,T2) |
| (9) | (−,T2,1,T3) |
| (10) | (:=,T3,_,a) |
| (11) | (j,_,_,(1)) |
5. 设有基本块
D:=A-C
E:=A*C
F:=D*E
S:=2
T:=A-C
Q:=A*C
G:=2*S
J:=T*Q
K:=G*5
L:=K+J
M:=L
假设基本块出口时只有 M 还被引用,请写出优化后的四元序列。
答:优化后的四元序列:
D:=A-C
E:=A*C
F:=D*E
M:=F+20
6. 已知文法 G(S)
S→a∣ˆ∣(T)
T→T,S∣S
(1) 给出句子 (a,(a,a)) 的最左推导;
(2) 给出句型 ((T,S),a) 的短语、直接短语、句柄。
答:最左推导:
S⇒(T)⇒(T,S)⇒(S,S)⇒(a,S)⇒(a,(T))⇒(a,(T,S))⇒(a,(S,S))⇒(a,(a,S))⇒(a,(a,a))
7. 对于 C 语言 do S while E 语句
(1) 改写文法,使之适合语法制导翻译;
(2) 写出改写后产生式的语义动作。
答:
(1) S→doM1S1whileM2E
M→ε
(2) M→ε {M.quad=nextquad;}
S→doM1S1whileM2E {backpatch(S1.nextlist,M2.quad);backpatch(E.truelist,M1.quad);S.nextlist=E.falselist;}
8. 已知文法 G(S)
S→aAcBe
A→Ab∣b
B→d
(1) 给出句子 abbcde 的最左推导及画出语法树;
(2) 给出句型 aAbcde 的短语、素短语。
答:(1) S⇒aAcBe⇒aAbcBe⇒abbcBe⇒abbcde
(2) 短语:aAbcde,Ab,d。素短语:Ab,d。
9. 设文法 G(S):
S→(T)∣aS∣a
T→T,S∣S
(1) 消除左递归和提公共左因子;
(2) 构造相应的FIRST和FOLLOW集合;
(3) 构造预测分析表。
答:(1) S→(L)∣aS′,S′→S∣ε,L→SL′,L′→,SL′∣ε
(2) FIRST(S)={a,(},FIRST(S′)={a,(,ε},FIRST(L)={a,(},FIRST(L′)={,,ε},FOLLOW(S)={,,),#},FOLLOW(S′)={,,),#},FOLLOW(L)={)},FOLLOW(L′)={)}
(3) 预测分析表:
| ( | ) | a | , | # |
|---|
| S | S→(L) | | S→aS′ | | |
| S′ | S′→S | S′→ε | S′→S | S′→ε | S′→ε |
| L | L→SL′ | | L→SL′ | | |
| L′ | | L′→ε | | L′→,SL′ | |
10. 把语句
if X>0 ∨ Y<0
then while X>0 do X:=A*3
else Y:=B+3;
翻译成四元式序列。
答:
| 四元式 |
|---|
| (1) | (j>,X,0,(5)) |
| (2) | (j,_,_,(3)) |
| (3) | (j<,Y,0,(5)) |
| (4) | (j,_,_,(11)) |
| (5) | (j>,X,0,(7)) |
| (6) | (j,_,_,(11)) |
| (7) | (∗,A,3,T1) |
| (8) | (:=,T1,_,X) |
| (9) | (j,_,_,(5)) |
| (10) | (j,_,_,(12)) |
| (11) | (+,B,3,T2) |
| (12) | (:=,T2,_,Y) |
11. 已知文法 G(S)
E→E+T∣T
T→T∗F∣F
F→(E)∣i
(1) 给出句型 (i+i)∗i+i 的最左推导及画出语法树;
(2) 给出句型 (E+T)∗i+F 的短语,素短语和最左素短语。
答:(1) 最左推导:
E⇒E+T⇒T+T⇒T∗F+T⇒F∗F+T⇒(E)∗F+T⇒(E+T)∗F+T⇒(T+T)∗F+T⇒(F+T)∗F+T⇒(i+T)∗F+T⇒(i+F)∗F+T⇒(i+i)∗F+T⇒(i+i)∗i+T⇒(i+i)∗i+F⇒(i+i)∗i+i
(2) 短语:i,E+T,(E+T)∗i+F,(E+T)∗i。素短语:i,E+T。最左素短语:E+T。
五、计算题#
1. 设文法 G(S):
S→ˆ∣a∣(T)
T→T,S∣S
(1) 消除左递归;
(2) 构造相应的FIRST和FOLLOW集合;
(3) 构造预测分析表。
2. 语句 if E then S
(1) 改写文法,使之适合语法制导翻译;
(2) 写出改写后产生式的语义动作。
答:
(1) 产生式:
- C→ifEthen
- S→CS(1)
(2) 语义动作:
- C→ifEthen
{BACK(E.TC,NXQ);C.chain:=E.FC}
- S→CS(1)
{S.chain:=MERG(C.chain,S(1).chain)}
3. 设某语言的for语句的形式为
for i:=E(1) to E(2) do S
(1) 写出适合语法制导翻译的产生式;
(2) 写出每个产生式对应的语义动作。
答:
(1) 产生式:
- F→fori:=E(1)toE(2)do
- S→FS(1)
(2) 语义动作:
- F→fori:=E(1)toE(2)do
{GEN(:=,E(1).place,_,entry(i));F.place:=entry(i);LIMIT:=Newtemp;GEN(:=,E(2).place,_,LIMIT);Q:=NXQ;F.QUAD:=q;GEN(j≤,entry(i),LIMIT,q+2);F.chain:=NXQ;GEN(j,_,_,0)}
- S→FS(1)
{BACKPATCH(S(1).chain,NXQ);GEN(+,F.place,1,F.place);GEN(j,_,_,F.QUAD);S.chain:=F.chain}
《编译原理》期末试题(三)#
一、简答题#
1. 从优化的范围的角度,优化可以分哪两类?对循环的优化可以有哪三种?
答:从优化的范围的角度,优化可以分为局部优化和全局优化两类;对循环的优化有三种:循环不变表达式外提、归纳变量删除与计算强度削减。
2. 写出表达式 a=b∗c+b∗d 对应的逆波兰式、四元式序列和三元式序列。
答:逆波兰式:abc∗bd∗+:=
四元式序列:
| OP | ARG1 | ARG2 | RESULT |
|---|
| (1) | ∗ | b | c | t1 |
| (2) | ∗ | b | d | t2 |
| (3) | + | t1 | t2 | t3 |
| (4) | := | t3 | | a |
三元式序列:
| OP | ARG1 | ARG2 |
|---|
| (1) | ∗ | b | c |
| (2) | ∗ | b | d |
| (3) | + | (1) | (2) |
| (4) | := | (3) | a |
3. 对于文法 G(S):S→(T)∣a,T→T,S∣S,画出句子 (a,(a,a)) 的语法树,并给出句型 (T,a,(T)) 的所有短语、直接短语、句柄。
答:短语:a,T,a,(T),T,a,(T),(T,a,(T))。直接短语:a,(T)。句柄:a。
4. 设有字母表 {a,b} 上的正规式 R=(ab∣a)∗。
(1) 构造相应的NFA;
(2) 将NFA确定化为DFA;
(3) 对DFA化简;
(4) 令状态分别对应非终结符,写出等价文法。
答:(1) NFA构造略。
(2) 确定化后的DFA状态转换表:
| 状态 | a | b |
|---|
| →0 | {1,2} | |
| 1 | | {0} |
| +2 | {1,2} | |
(3) 化简:合并状态0和2为状态2。
(4) 文法:A→aB∣ε,B→aB∣bA∣ε
5. 设将文法 G 改写成等价的 LL(1) 文法,并构造预测分析表。
G:S→S∗aT∣aT∣∗aT,T→+aT∣+a
答:消除左递归后的文法 G′:
S→aTS′∣∗aTS′
S′→∗aTS′∣ε
T→+aT∣+a
提取左公因子得文法 G′′:
S→aTS′∣∗aTS′
S′→∗aTS′∣ε
T→+aT′
T′→T∣ε
验证 G′′ 是 LL(1) 文法:
Select(S→aTS′)∩Select(S→∗aTS′)={a}∩{∗}=Φ
Select(S′→∗aTS′)∩Select(S′→ε)={∗}∩{#}=Φ
Select(T→+aT′)={+}
Select(T′→T)∩Select(T′→ε)={+}∩{∗,#}=Φ
所以该文法是 LL(1) 文法。
预测分析表:
| + | ∗ | a | # |
|---|
| S | | S→∗aTS′ | S→aTS′ | |
| S′ | | S′→∗aTS′ | | S′→ε |
| T | T→+aT′ | | | |
| T′ | T′→T | T′→ε | | T′→ε |
6. 设文法 G 为:S→A,A→BA∣ε,B→aB∣b
(1) 拓广文法 G′;
(2) 构造识别活前缀的DFA;
(3) 构造 LR(1) 分析表;
(4) 分析输入串 abab。
答:(1) 拓广文法 G′:
(0) S′→S,(1) S→A,(2) A→BA,(3) A→ε,(4) B→aB,(5) B→b
FIRST(A)={ε,a,b},FIRST(B)={a,b}
(2) 构造的DFA(项目集规范族)如下图所示:
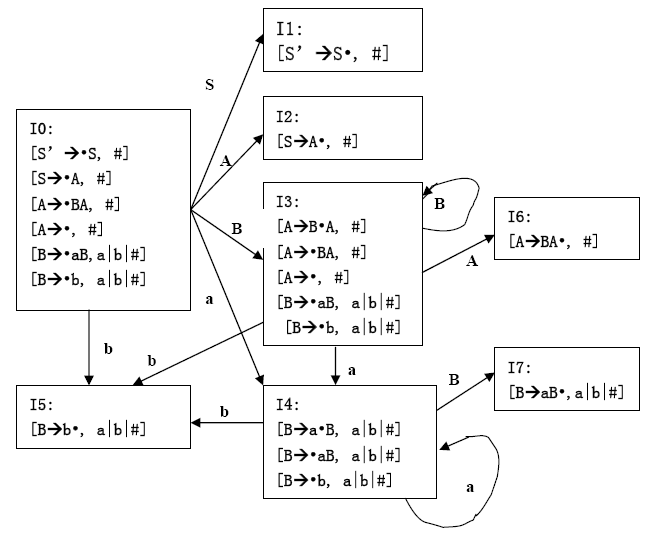
图 6.1 LR(1) 活前缀 DFA
(3) 从项目集规范族看出,不存在冲突动作,∴该文法是 LR(1) 文法。其 LR(1) 分析表如下表所示:
| 状态 | ACTION | | | GOTO | | |
|---|
| a | b | # | S | A | B |
| 0 | S4 | S5 | r3 | 1 | 2 | 3 |
| 1 | | | acc | | | |
| 2 | | | r1 | | | |
| 3 | S4 | S5 | r3 | | 6 | 3 |
| 4 | S4 | S5 | | | | 7 |
| 5 | r5 | r5 | r5 | | | |
| 6 | | | r2 | | | |
| 7 | r4 | r4 | r4 | | | |
(4) 对输入串 abab# 的分析过程如下表所示:
| 步骤 | 状态栈 | 符号栈 | 剩余输入串 | ACTION | GOTO |
|---|
| 1 | 0 | # | abab# | S4 | |
| 2 | 0 4 | #a | bab# | S5 | |
| 3 | 0 4 5 | #ab | ab# | r5(B→b) | 7 |
| 4 | 0 4 7 | #aB | ab# | r4(B→aB) | 3 |
| 5 | 0 3 | #B | ab# | S4 | |
| 6 | 0 3 4 | #Ba | b# | S5 | |
| 7 | 0 3 4 5 | #Bab | # | r5(B→b) | 7 |
| 8 | 0 3 4 7 | #BaB | # | r4(B→aB) | 3 |
| 9 | 0 3 3 | #BB | # | r3(A→ε) | 6 |
| 10 | 0 3 3 6 | #BBA | # | r2(A→BA) | 6 |
| 11 | 0 3 6 | #BA | # | r2(A→BA) | 2 |
| 12 | 0 2 | #A | # | r1(S→A) | 1 |
| 13 | 0 1 | #S | # | acc | |
7. 简答题:设有文法 G[S]:S→S(S)S∣ε,该文法是否为二义文法?说明理由。
答:是二义的,因为对于 ()() 可以构造两棵不同的语法树。
8. 给定文法 G[S]:
S→aA∣bQ,A→aA∣bB∣b,B→bD∣aQ,Q→aQ∣bD∣b,D→bB∣aA
构造相应的最小的DFA。
答:先构造其NFA,用子集法将NFA确定化:
| a | b |
|---|
| S | A | Q |
| A | A | BZ |
| Q | Q | DZ |
| BZ | Q | D |
| DZ | A | B |
| D | A | B |
| B | Q | D |
将 S,A,Q,BZ,DZ,D,B 重新命名为 0,1,2,3,4,5,6。因为3、4中含有Z,所以它们为终态。
| a | b |
|---|
| 0 | 1 | 2 |
| 1 | 1 | 3 |
| 2 | 2 | 4 |
| 3 | 2 | 5 |
| 4 | 1 | 6 |
| 5 | 1 | 6 |
| 6 | 2 | 5 |
最小化:令 P0=({0,1,2,5,6},{3,4}),用 b 进行分割得 P1=({0,5,6},{1,2},{3,4}),再用 b 进行分割得 P2=({0},{5,6},{1,2},{3,4})。
令 {0} 为 A,{1,2} 为 B,{3,4} 为 C,{5,6} 为 D。
| a | b |
|---|
| A | B | B |
| B | B | C |
| C | B | D |
| D | B | D |
9. 对文法 G(S):S→a∣ˆ∣(T),T→T,S∣S
(1) 构造算符优先关系表;
(2) 判断是否是算符优先文法;
(3) 给出输入串 (a,a)# 的算符优先分析过程。
答:(1)(2) 是算符优先文法,因为任何两个终结符之间至多只有一种优先关系。
(3) 输入串 (a,a)# 的算符优先分析过程:
| 步骤 | 栈 | 当前输入字符 | 剩余输入串 | 动作 |
|---|
| 1 | # | ( | a,a# | #<( 移进 |
| 2 | #($ | a | ,a)# | (<a 移进 |
| 3 | #(a | , | a)# | a>, 归约 |
| 4 | #(N | , | a)# | (<, 移进 |
| 5 | #(N, | a | )# | ,<a 移进 |
| 6 | #(N,a | ) | # | a>) 归约 |
| 7 | #(N,N | ) | # | ,>) 归约 |
| 8 | #(N) | | # | (=) 移进 |
| 9 | #(N) | # | | )># 归约 |
| 10 | #N | # | | 接受 |
《编译原理》期末试题(四)#
一、简述编译程序的工作过程(10分)#
编译程序的工作过程,是指从输入源程序开始到输出目标程序为止的整个过程,是非常复杂的,就其过程而言,一般可以划分为五个工作阶段:
① 词法分析,对构成源程序的字符串进行扫描和分解,识别出一个个的单词;
② 语法分析,根据语言的语法规则,把单词符号串分解成各类语法单位;
③ 语义分析与中间代码产生,即对各类语法单位,分析其含义并进行初步翻译;
④ 代码优化,以期产生更高效的代码;
⑤ 目标代码生成,把中间代码变换成特定机器上的低级语言指令形式。
二、构造下列正规式相应的DFA(用状态转换图表示)(15分)#
- 1(0∣1)∗1
- 0∗10∗10∗10∗1
- letter(letter∣digit)∗
(DFA状态转换图略)
三、给出下面语言的相应文法(15分)#
L1={anbn∣n≥1},L2={anbm+nam∣n≥1,m≥0}
答:
G1:A→aAb∣ab
G1:S→AB,A→aAb∣ab,B→bB∣ε
四、对下面的文法 G(15分)#
S→a∣b∣(T)
T→T,S∣S
(1) 消去文法的左递归,得到等价的文法 G2;
(2) 判断文法 G2 是否 LL(1) 文法,如果是,给出其预测分析表。
答:G2:
S→a∣b∣(T)
T→ST′
T′→,ST′∣ε
G2 是 LL(1) 文法。
预测分析表:
| a | b | ( | ) | , | # |
|---|
| S | S→a | S→b | S→(T) | | | |
| T | T→ST′ | T→ST′ | T→ST′ | | | |
| T′ | | | | T′→ε | T′→,ST′ | T′→ε |
五、设有文法 G[A](15分)#
A→BCc∣gDB
B→bCDE∣ε
C→DaB∣ca
D→dD∣ε
E→gAf∣c
(1) 计算该文法的每一个非终结符的FIRST集和FOLLOW集;
(2) 试判断该文法是否为 LL(1) 文法。
答:(计算略)是 LL(1) 文法。
六、有定义二进制整数的文法如下(15分)#
L→LB∣B,B→0∣1
构造一个翻译模式,计算该二进制数的值(十进制的值)。
答:引入 L、B 的综合属性 val,翻译模式为:
S→L {print(L.val)}
L→L1B {L.val=L1.val×2+B.val}
L→B {L.val=B.val}
B→0 {B.val=0}
B→1 {B.val=1}
《编译原理》期末试题(五)#
一、单项选择题(共10小题,每小题2分,共20分)#
1. 语言是
- A. 句子的集合
- B. 产生式的集合
- C. 符号串的集合
- D. 句型的集合
2. 编译程序前三个阶段完成的工作是
- A. 词法分析、语法分析和代码优化
- B. 代码生成、代码优化和词法分析
- C. 词法分析、语法分析、语义分析和中间代码生成
- D. 词法分析、语法分析和代码优化
3. 一个句型中称为句柄的是该句型的最左
- A. 非终结符号
- B. 短语
- C. 句子
- D. 直接短语
4. 下推自动机识别的语言是
- A. 0型语言
- B. 1型语言
- C. 2型语言
- D. 3型语言
5. 扫描器所完成的任务是从字符串形式的源程序中识别出一个个具有独立含义的最小语法单位即
6. 对应Chomsky四种文法的四种语言之间的关系是
- A. L0⊂L1⊂L2⊂L3
- B. L3⊂L2⊂L1⊂L0
- C. L3=L2⊂L1⊂L0
- D. L0⊂L1⊂L2=L3
7. 词法分析的任务是
- A. 识别单词
- B. 分析句子的含义
- C. 识别句子
- D. 生成目标代码
8. 常用的中间代码形式不含
- A. 三元式
- B. 四元式
- C. 逆波兰式
- D. 语法树
9. 代码优化的目的是
- A. 节省时间
- B. 节省空间
- C. 节省时间和空间
- D. 把编译程序进行等价交换
10. 代码生成阶段的主要任务是
- A. 把高级语言翻译成汇编语言
- B. 把高级语言翻译成机器语言
- C. 把中间代码变换成依赖具体机器的目标代码
- D. 把汇编语言翻译成机器语言
二、填空题(本大题共5小题,每小题2分,共10分)#
1. 编译程序首先要识别出源程序中每个(单词),然后再分析每个(句子)并翻译其意义。
2. 编译器常用的语法分析方法有(自底向上)和(自顶向下)两种。
3. 通常把编译过程分为分析前端与综合后端两大阶段。词法、语法和语义分析是对源程序的(分析),中间代码生成、代码优化与目标代码的生成则是对源程序的(综合)。
4. 程序设计语言的发展带来了日渐多变的运行时存储管理方案,主要分为两大类,即(静态存储分配)方案和(动态存储分配)方案。
5. 对编译程序而言,输入数据是(源程序),输出结果是(目标程序)。
三、名词解释题(共5小题,每小题4分,共20分)#
1. 词法分析
答:词法分析的主要任务是从左向右扫描每行源程序的符号,按照词法规则从构成源程序的字符串中识别出一个个具有独立意义的最小语法单位,并转换成统一的内部表示(token),送给语法分析程序。
2. LL(1)文法
答:若文法的任何两个产生式 A→α∣β 都满足下面两个条件:
(1) FIRST(α)∩FIRST(β)=Φ;
(2) 若 β⇒∗ε,那么 FIRST(α)∩FOLLOW(A)=Φ。
我们把满足这两个条件的文法叫做LL(1)文法,其中的第一个L代表从左向右扫描输入,第二个L表示产生最左推导,1代表在决定分析器的每步动作时向前看一个输入符号。除了没有公共左因子外,LL(1)文法还有一些明显的性质,它不是二义的,也不含左递归。
3. 语法树
答:句子的树结构表示法称为语法树(语法分析树或语法推导树)。给定文法 G=(VN,VT,P,S),对于 G 的任何句型都能构造与之关联的语法树。这棵树具有下列特征:
(1) 根节点的标记是开始符号 S。
(2) 每个节点的标记都是 V 中的一个符号。
(3) 若一棵子树的根节点为 A,且其所有直接子孙的标记从左向右的排列次序为 A1A2⋯AR,那么 A→A1A2⋯AR 一定是 P 中的一条产生式。
(4) 若一标记为 A 的节点至少有一个除它以外的子孙,则 A∈VN。
(5) 若树的所有叶节点上的标记从左到右排列为字符串 w,则 w 是文法 G 的句型;若 w 中仅含终结符号,则 w 为文法 G 所产生的句子。
4. LR(0)分析器
答:所谓LR(0)分析,是指从左至右扫描和自底向上的语法分析,且在分析的每一步,只须根据分析栈当前已移进和归约出的全部文法符号,并至多再向前查看0个输入符号,就能确定相对于某一产生式左部符号的句柄是否已在分析栈的顶部形成,从而也就可以确定当前所应采取的分析动作(是移进还是按某一产生式进行归约等)。
5. 语言和文法
答:文法就是语言结构的定义和描述,是有穷非空的产生式集合。文法 G 定义为四元组的形式:G=(VN,VT,P,S),其中:VN 是非空有穷集合,称为非终结符号集合;VT 是非空有穷集合,称为终结符号集合;P 是产生式的集合(非空);S 是开始符号(或识别符号)。这里,VN∩VT=Φ,S∈VN。V=VN∪VT,称为文法 G 的字母表,它是出现文法产生式中的一切符号的集合。
文法 G 所描述的语言用 L(G) 表示,它由文法 G 所产生的全部句子组成,即 L(G)={x∣S⇒∗x,其中S为文法开始符号,且x∈VT∗}。简单的说,文法描述的语言是该文法一切句子的集合。
四、简答题(共4小题,每小题5分,共20分)#
1. 编译程序和高级语言有什么区别?
答:用汇编语言或高级语言编写的程序,必须先送入计算机,经过转换成用机器语言表示的目标程序(这个过程即编译),才能由计算机执行。执行转换过程的程序叫编译程序。编译程序的工作情况有三种:汇编型、解释型和编译型。汇编型编译程序用来将汇编语言编写的程序,按照一一对应的关系,转换成用机器语言表示的程序。解释型编译程序将高级语言程序的一个语句,先解释成为一组机器语言的指令,然后立即执行。编译型编译程序将高级语言编写的程序,一次全部翻译成机器语言表示的程序。
2. 编译程序的工作分为哪几个阶段?
答:词法分析、语法分析和语义分析是对源程序进行的分析(称为编译程序的前端),而中间代码生成、代码优化和代码生成三个阶段合称为对源程序进行综合(称为编译程序的后端),它们从源程序的中间表示建立起和源程序等价的目标程序。
3. 简述自下而上的分析方法。
答:所谓自下而上分析法就是从输入串开始,逐步进行”归约”,直至归约到文法的开始符号;或者说从语法树的末端开始,步步向上”归约”,直到根节点。
4. 简述代码优化的目的和意义。
答:代码优化是尽量生成”好”的代码的编译阶段。也就是要对程序代码进行一种等价变换,在保证变换前后代码执行结果相同的前提下,尽量使目标程序运行时所需要的时间短,同时所占用的存储空间少。
五、综合应用题(共3小题,每小题10分,共30分)#
1. 证明下述文法 G:S→aSbS∣aS∣d 是二义性文法。
答:一个文法,如果存在某个句子有不只一棵语法分析树与之对应,那么称这个文法是二义性文法。句子 aadbd 有两棵语法树,由此可知,S→aSbS∣aS∣d 定义的文法是二义性文法。
2. 对于文法 G[S]:S→AB,A→Aa∣bB,B→a∣Sb,求句型 baSb 的全部短语、直接短语和句柄?
答:baSb 为句型 baSb 的相对于 S 的短语,ba 为句型 baSb 的相对于 A 的短语,Sb 为句型 baSb 的相对于 B 的短语,且为直接短语,a 为句型 baSb 的相对于 B 的短语,且为直接短语和句柄。
3. 设有非确定的有限自动机 NFA M=({A,B,C},{0,1},δ,{A},{C}),其中:δ(A,0)={C},δ(A,1)={A,B},δ(B,1)={C},δ(C,1)={C}。请画出状态转换矩阵和状态转换图。
答:状态转换矩阵为:
| 0 | 1 |
|---|
| A | C | A,B |
| B | | C |
| C | | C |
状态转换图略。
《编译原理》期末试题(六)#
一、单项选择题#
1. ____型文法也称为正规文法。
2. ____文法不是LL(1)的。
- A. 递归
- B. 右递归
- C. 2型
- D. 含有公共左因子的
3. 文法 E→E+E∣E∗E∣i 的句子 i∗i+i∗i 的不同语法分析树的总数为______。
4. 四元式之间的联系是通过______实现。
- A. 临时变量
- B. 指示器
- C. 符号表
- D. 程序变量
5. 同心集合并可能会产生的新冲突为______。
- A. 二义
- B. 移进/移进
- C. 移进/归约
- D. 归约/归约
6. 代码优化时所依据的是______。
- A. 语法规则
- B. 词法规则
- C. 等价变换规则
- D. 语义规则
7. 表达式 a−(−b)∗c 的逆波兰表示为______。(注:@为单目减运算符)
- A. a−b@c∗
- B. ab@c∗−
- C. ab@−
- D. ab@c−∗
8. 过程的DISPLAY表记录了______。
- A. 过程的连接数据
- B. 过程的嵌套层次
- C. 过程的返回地址
- D. 过程的入口地址
二、填空题#
1. 对于文法 G1 和 G2,若有 L(G1)=L(G2)(或 G1 和 G2 的语言相同),则称文法 G1 和 G2 是等价的。
2. 对于文法 G[E]:E→T∣E+T,T→F∣T∗F,F→PˆF∣P,P→(E)∣i,句型 T+T∗F+i 的句柄是 T,最左素短语是 T∗F。
3. 最右推导的逆过程称为规范归约,也称为最左归约。
4. 规范归约中的可归约串是句柄,算符优先分析中的可归约串是最左素短语。
5. (A∨B)∧(C∨¬D∧E) 的逆波兰式是 AB∨CD¬E∧∨∧。
6. 在属性文法中文法符号的两种属性分别称为继承属性和综合属性(次序可换)。
7. 符号表的每一项是由名字栏和地址分配两个栏目组成。在目标代码生成阶段,符号表是地址分配的依据。
8. 一个过程的DISPLAY表的内容是它的直接外层的DISPLAY表的内容加上本过程的SP的地址。
三、有穷自动机#
构造一个最小的DFA M,使其接受字母表 Σ={0,1} 上所有满足下述条件的串:每个1都有0直接跟在右边。并构造和 M 等价的正规式。
答:最小的 DFA M 如下图所示:
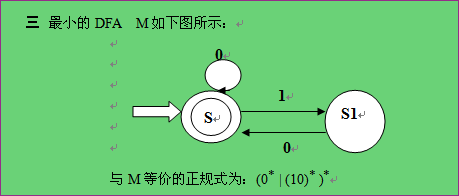
图 3.1 最小的 DFA M
与 M 等价的正规式为:(0∗∣(10)∗)∗ (或写为更简化的 (0∣10)∗)
四、证明题#
证明正规式 (ab)∗a 与正规式 a(ba)∗ 等价(用构造它们的最小的DFA方法)。
答:证明过程如下图所示:
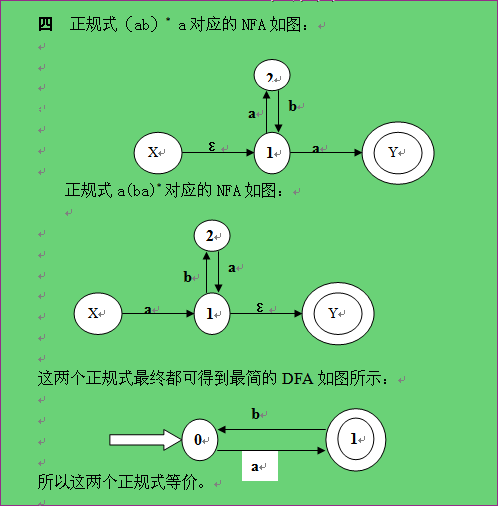
图 4.2 正规式等价性构造证明
五、写一个文法#
写一个文法,使其语言是 L={1n0m1m0n∣m,n≥0}。
答:文法 G:S→1S0∣A,A→0A1∣ε
六、对文法 G[S]#
S→aSb∣P
P→bPc∣bQc
Q→Qa∣a
(1) 它是否是算符优先文法?请构造算符优先关系表。
(2) 文法 G[S] 消除左递归、提取左公因子后是否是 LL(1) 文法?请证实。
答:消除左递归和提取左公因子后的文法为:
S→aSb∣P
P→bP′
P′→Pc∣Qc
Q→aQ′
Q′→aQ′∣ε
求具有相同左部的两个产生式的Select集的交集:
Select(S→aSb)∩Select(S→P)={a}∩First(P)={a}∩{b}=Φ
Select(P′→Pc)∩Select(P′→Qc)=First(P)∩First(Q)={b}∩{a}=Φ
Select(Q′→aQ′)∩Select(Q′→ε)={a}∩Follow(Q)={a}∩{c}=Φ
所以修改后的文法是 LL(1) 文法。
《编译原理》期末试题(七)#
一、回答下列问题(30分)#
1. 什么是S-属性文法?什么是L-属性文法?它们之间有什么关系?
答:S-属性文法是只含有综合属性的属性文法。
L-属性文法要求对于每个产生式 A→X1X2⋯Xn,其每个语义规则中的每个属性或者是综合属性,或者是 Xj 的一个继承属性,且该属性仅依赖于:产生式 Xj 的左边符号 X1,X2⋯Xj−1 的属性;A 的继承属性。
S-属性文法是L-属性文法的特例。
2. 什么是句柄?什么是素短语?
答:一个句型的最左直接短语称为该句型的句柄。素短语是这样的一个短语,它至少包含一个终结符并且不包含更小的素短语。
3. 划分程序的基本块时,确定基本块的入口语句的条件是什么?
答:(1) 程序第一个语句;或 (2) 能由条件转移语句或无条件转移语句转移到的语句;或 (3) 紧跟在条件转移语句后面的语句。
4. 运行时的DISPLAY表的内容是什么?它的作用是什么?
答:DISPLAY表是嵌套层次显示表。每当进入一个过程后,在建立它的活动记录区的同时建立一张嵌套层次显示表display。假定现在进入的过程层次为 i,则它的display表含有 i+1 个单元,自顶向下每个单元依次存放着现行层、直接外层、…、直至最外层(主程序,0层)等每层过程的最新活动记录的起始地址。通过DISPLAY表可以访问其外层过程的变量。
二、写一个文法(6分)#
写一个文法使其语言为 L(G)={anbmambn∣m,n≥1}。
答:文法 G(S):S→aSb∣B,B→bBa∣ba
三、对于文法 G(E)(8分)#
E→T∣E+T
T→F∣T∗F
F→(E)∣i
1. 写出句型 (T∗F+i) 的最右推导并画出语法树。
答:E⇒T⇒F⇒(E)⇒(E+T)⇒(E+F)⇒(E+i)⇒(T+i)⇒(T∗F+i)
2. 写出上述句型的短语,直接短语、句柄和素短语。
答:短语:(T∗F+i),T∗F+i,T∗F,i。直接短语:T∗F,i。句柄:T∗F。素短语:T∗F,i。
四、将语句翻译成四元式(8分)#
将语句 if (A<X) ∧ (B>0) then while C>0 do C:=C+D 翻译成四元式。
答:
| 四元式 |
|---|
| 100 | (j<,A,X,102) |
| 101 | (j,−,−,109) |
| 102 | (j>,B,0,104) |
| 103 | (j,−,−,109) |
| 104 | (j>,C,0,106) |
| 105 | (j,−,−,109) |
| 106 | (+,C,D,T1) |
| 107 | (:=,T1,−,C) |
| 108 | (j,−,−,104) |
| 109 | |
《编译原理》期末大题#
1. 消除左递归#
设有如下文法 G(S),试消除其左递归。
G(S):S→Ac∣c,A→Bb∣b,B→Sa∣a
解:S→abcS′∣bcS′∣cS′,S′→abcS′∣ε
2. 构造无左递归文法#
试构造与下面 G(S) 等价的无左递归的文法。
G(S):S→Sa∣Nb∣c,N→Sd∣Ne∣f
解:S→fN′bS′∣cS′,S′→aS′∣dN′bS′∣ε,N′→eN′∣ε
3. 构造LL(1)分析表#
设有文法 G(S):S→aBc∣bAB,A→aAb∣b,B→b∣ε
(1) 求各产生式的FIRST集,FOLLOW(A)和FOLLOW(B),以及各产生式的SELECT集。
(2) 构造LL(1)分析表,并分析符号串 baabbb 是否是该文法的句子。
解:(1)
FIRST(aBc)={a},FIRST(bAB)={b},FIRST(aAb)={a},FIRST(b)={b},FIRST(ε)={ε}
FOLLOW(A)={b,#},FOLLOW(B)={c,#}
SELECT(S→aBc)={a},SELECT(S→bAB)={b},SELECT(A→aAb)={a},SELECT(A→b)={b},SELECT(B→b)={b},SELECT(B→ε)={c,#}
(2) LL(1)分析表:
| a | b | c | # |
|---|
| S | S→aBc | S→bAB | | |
| A | A→aAb | A→b | | |
| B | | B→b | B→ε | B→ε |
分析符号串 baabbb 成功,baabbb 是该文法的句子。
4. 最左推导和语法树#
已知文法 G(S):S→a∣(T),T→T,S∣S
(1) 给出句子 ((a,a),a) 的最左推导并画出语法树;
(2) 给出句型 (T,a,(T)) 所有的短语、直接短语、素短语、最左素短语、句柄和活前缀。
解:(1) 最左推导:S⇒(T)⇒(T,S)⇒(S,S)⇒(a,S)⇒(a,(T))⇒(a,(T,S))⇒(a,(S,S))⇒(a,(a,S))⇒(a,(a,a))
语法树略。
(2) 句型 (T,a,(T)) 的分析:
短语:a,T,a,(T),T,a,(T),(T,a,(T))
直接短语:a,(T)
素短语:a,(T)
最左素短语:a
句柄:a
活前缀:ε,(,(T,(T,,(T,a,(T,a,(,(T,a,(T,(T,a,(T)
5. LR(0)项目集族和SLR(1)分析表#
设文法 G(S) 为:S→a∣aAb,S→b∣bBa,A→1A0∣ε,B→1B0∣ε
(1) 求LR(0)项目集族;
(2) 构造识别文法 G(E) 的DFA;
(3) 构造文法 G(E) 的SLR(1)分析表;
(4) 分析句子 a1100b 的识别过程。
解:(1)(2) LR(0)项目集族和识别活前缀的DFA略。
(3)(4) 略。


